Начните с доступа
Гайд про регистрацию и оплату Claude из России: текст со скриншотами, что делать, если не проходит карта.
- Старт с Claude 990 ₽
Схематично: вопрос про доступ и ответ из гайда
Гайд · 6 минут чтения
WebMCP, llms.txt и ai-catalog.json сверил с первоисточниками. Что из этого сайту нужно сейчас, а что можно спокойно отложить.
Разбор по 198 источникам, данные на 14/10/2026.
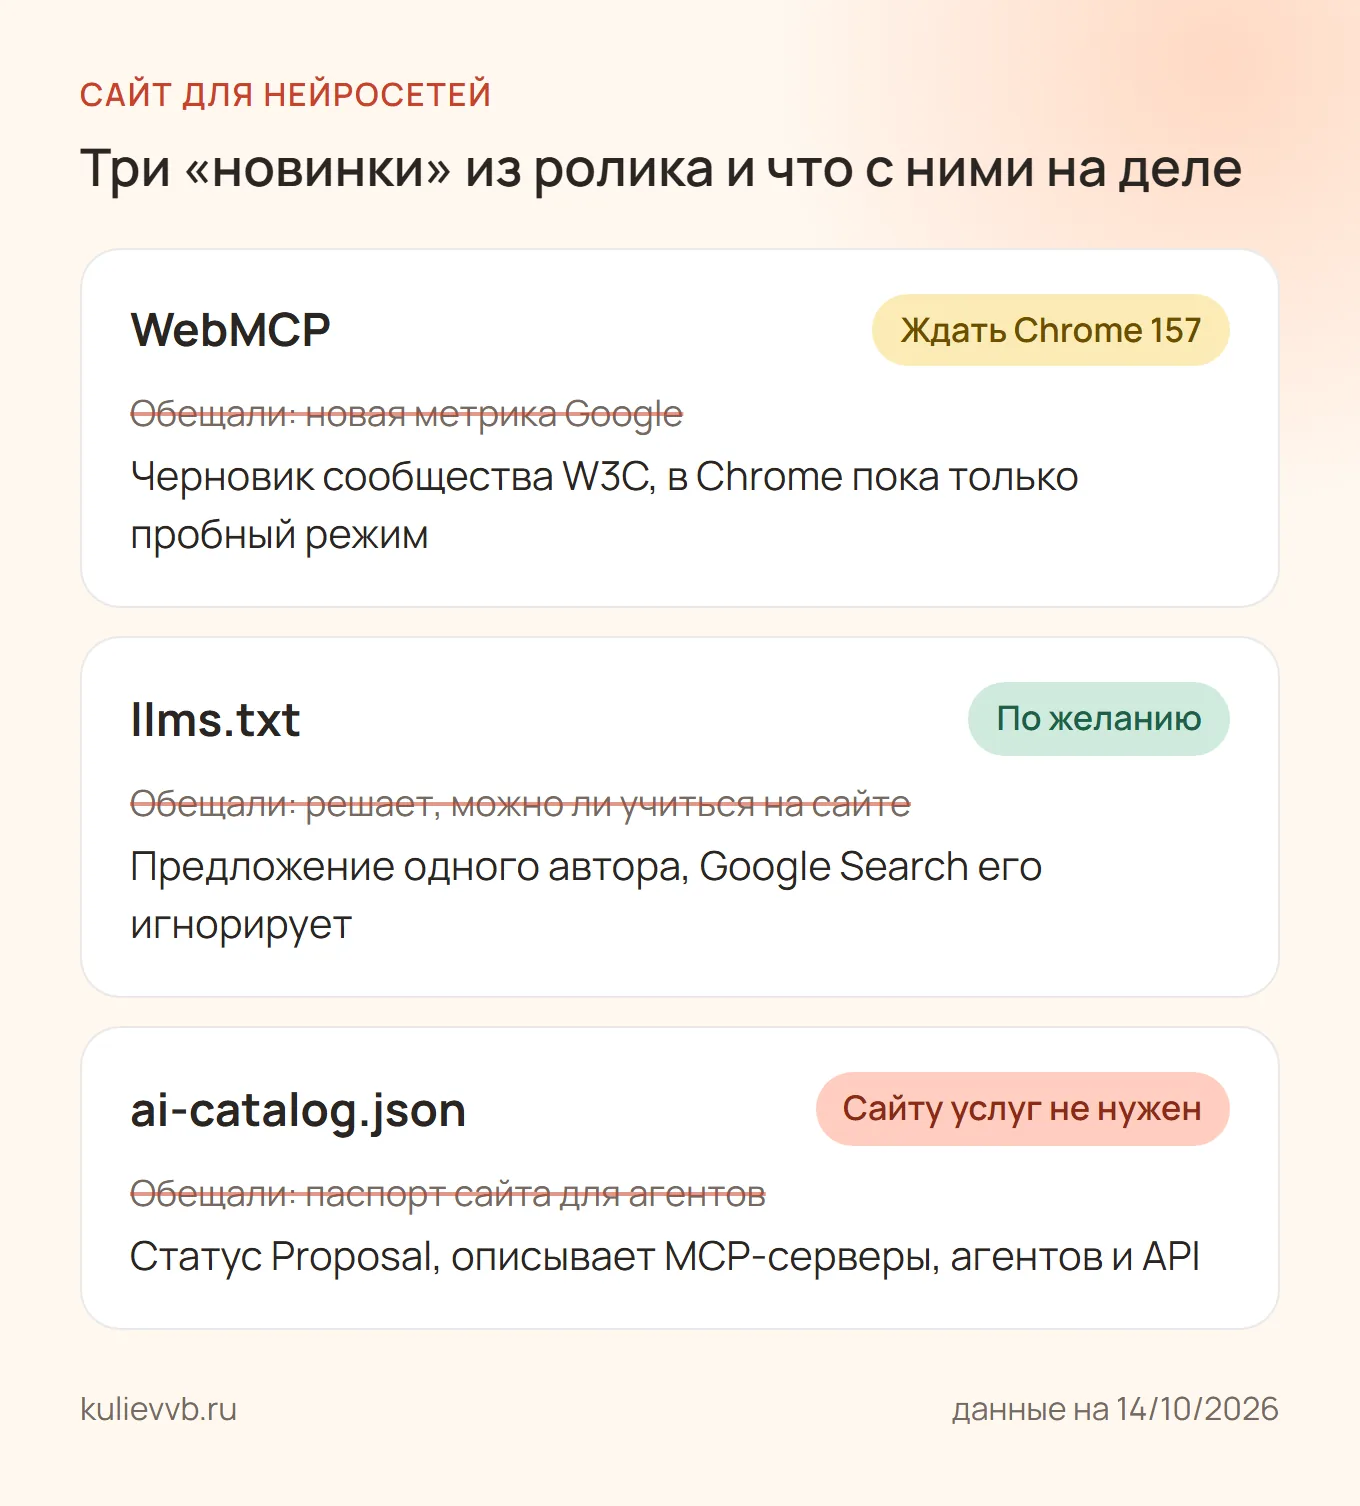
В ленте сейчас крутится ролик: «Google меняет интернет, готовьте сайты». Там три новые метрики для ИИ-агентов: WebMCP, файл llms.txt и файл ai-catalog.json. Обещают, что через год это станет стандартом.
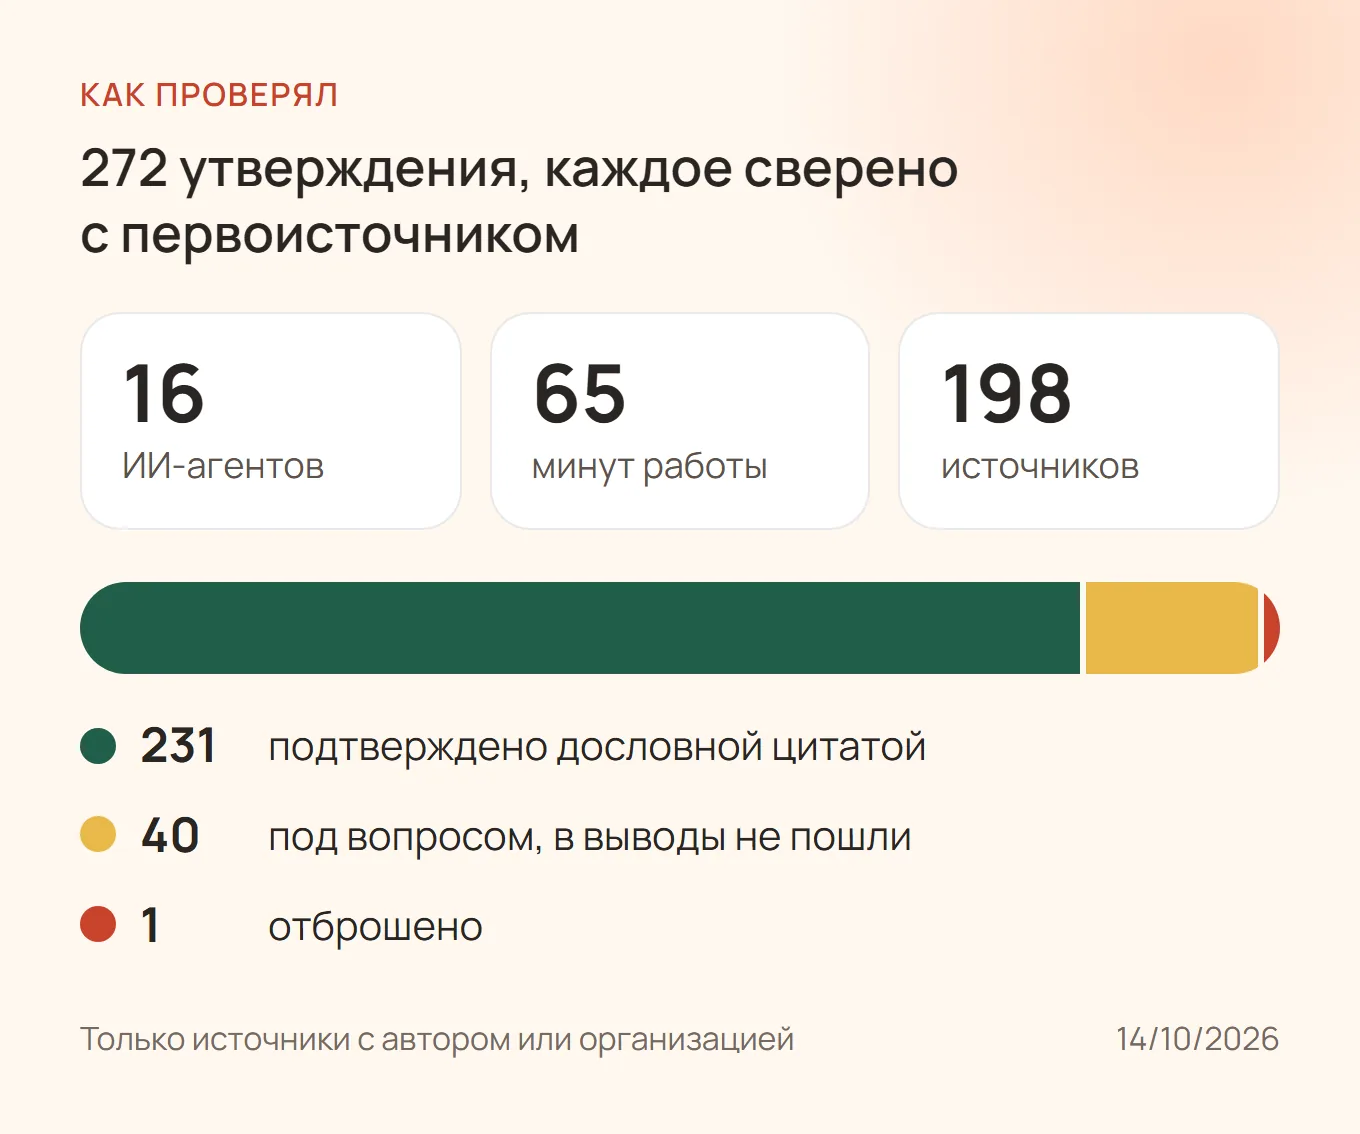
Звучит убедительно, я сам чуть не побежал переделывать сайт. Но я как раз собираю его новую версию, поэтому сначала проверил. Запустил 16 ИИ-агентов, они 65 минут сидели в спецификациях, документации Google, Яндекса, OpenAI, Anthropic и в замерах по логам. Нашли 272 утверждения, каждое сверили с первоисточником дословно. Подтвердилось 231, под вопросом 40, одно выкинули. Источники только с названным автором или организацией, перепечатки без автора в выборку не брал.
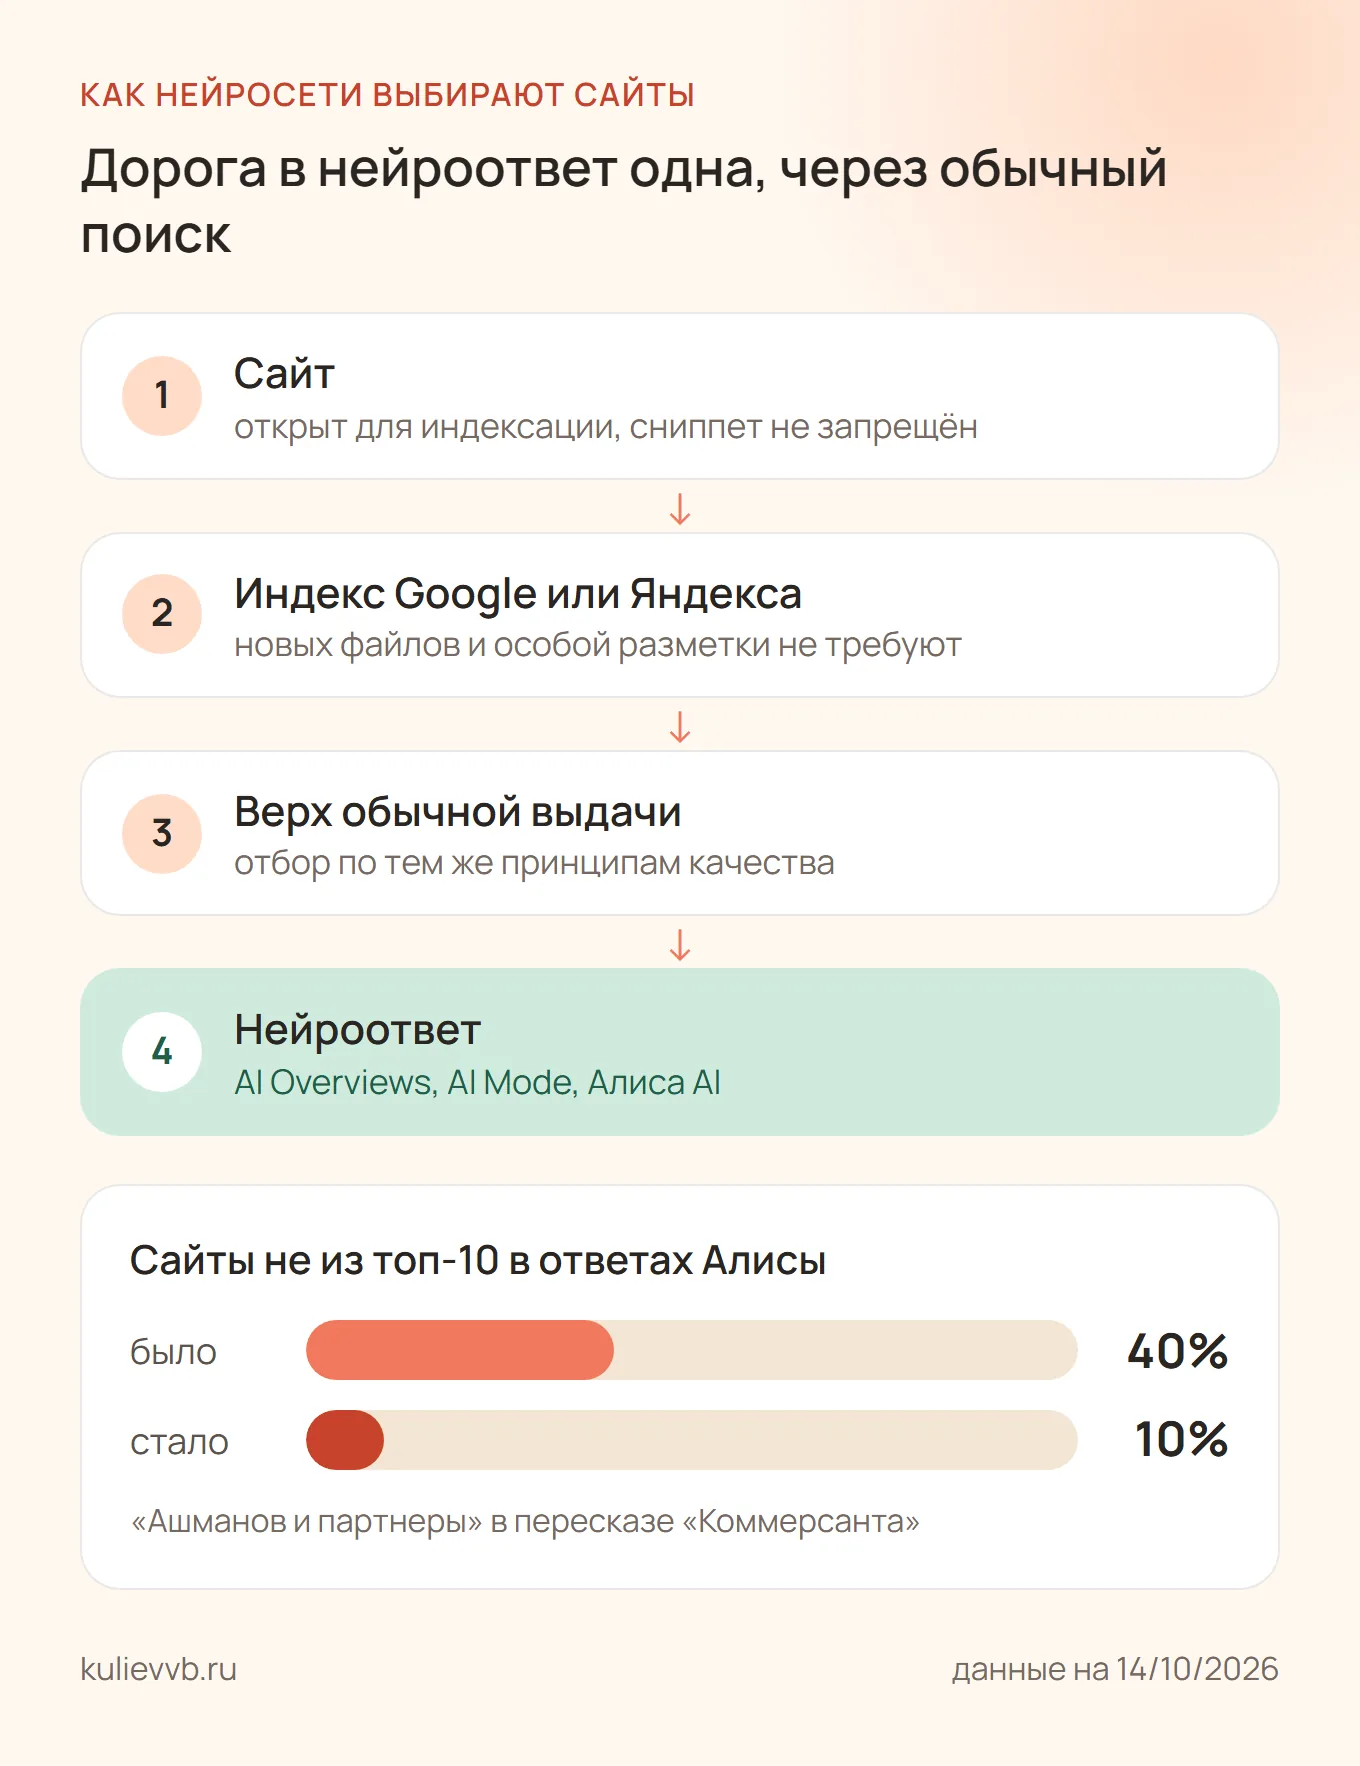
Google пишет прямо: для AI Overviews и AI Mode нет дополнительных требований, кроме индексации и права показывать сниппет. Оптимизация под генеративный поиск, по их же словам, «is still SEO». Новые машиночитаемые файлы и особая разметка для этого не нужны.
У Яндекса то же самое. Алиса AI берёт источники из тех, что высоко стоят в обычном Поиске. Принципиально новых требований к сайтам, по словам Яндекса, нет, отбор идёт по тем же принципам качества. По данным «Ашманова и партнеров», которые пересказал Коммерсант, доля сайтов не из топ-10 в ответах Алисы упала с 40% до 10%.
То есть, грубо говоря, в нейроответ попадает тот, кто и так хорошо стоит в поиске. Отдельной волшебной двери для ИИ нет.
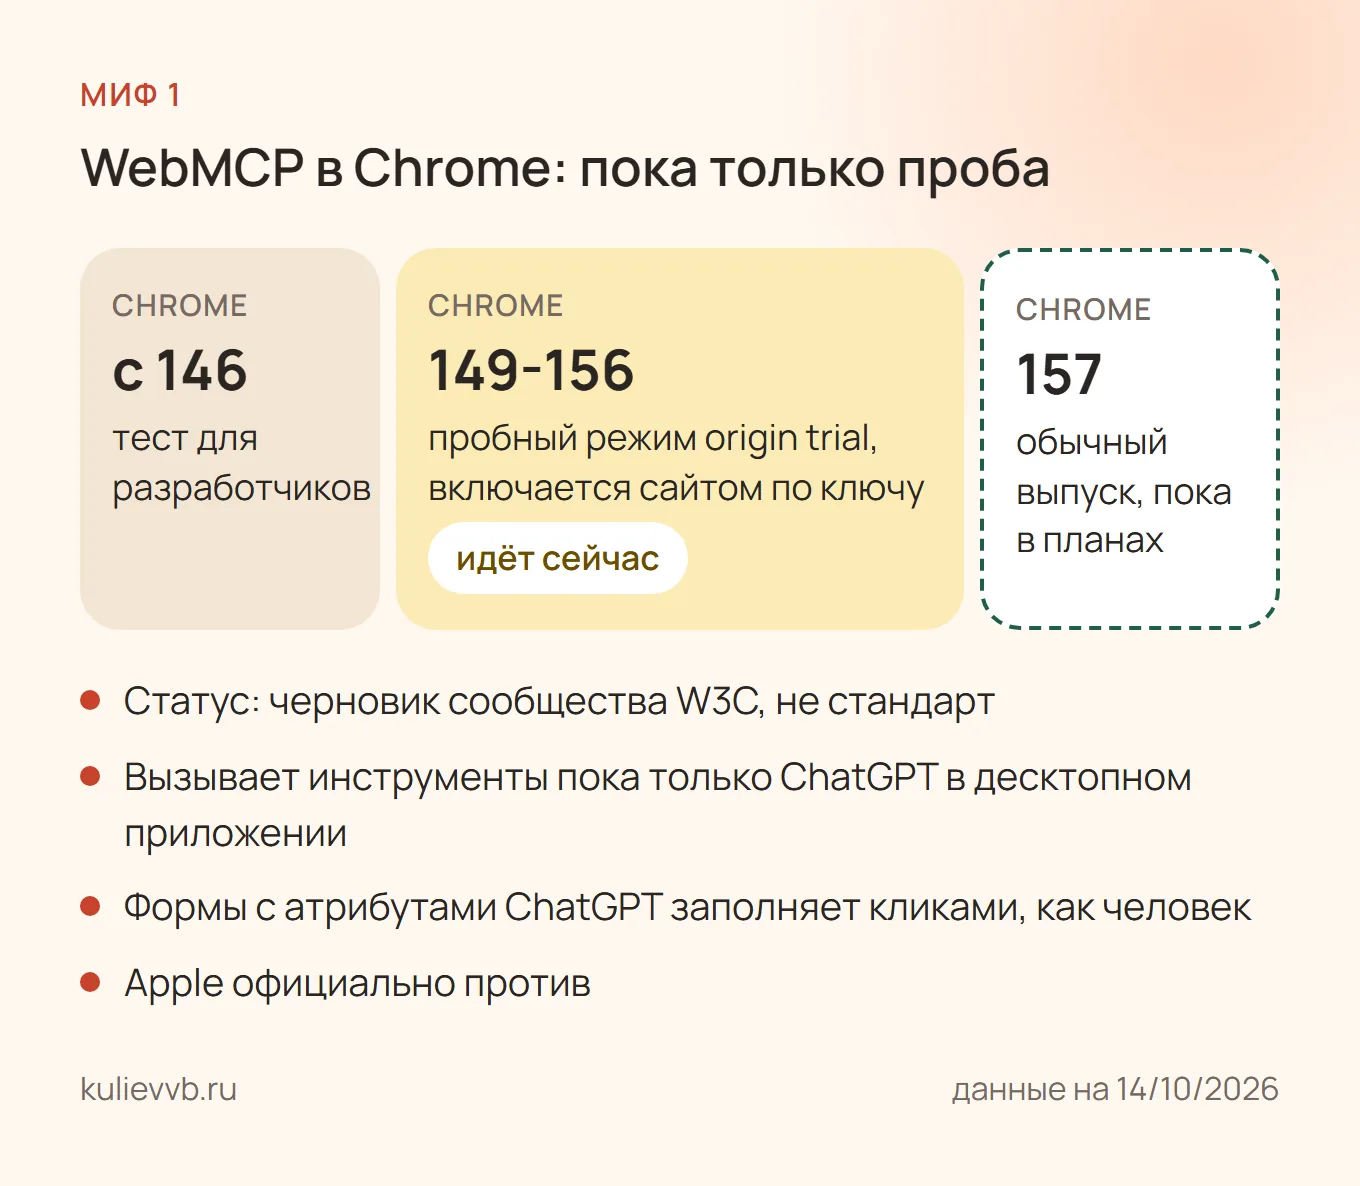
Что говорят. Сайт размечает формы, нейросеть получает готовые команды: записать клиента, оформить заказ. И не тыкает наугад.
Как есть. WebMCP существует, но это черновик сообщества W3C, не стандарт. В Chrome он в тестовом режиме (origin trial) с 149 по 156 версию, обычный выпуск запланирован на 157. Реально вызывает такие инструменты пока только ChatGPT в десктопном приложении, и только те, что написаны на JavaScript. Формы, размеченные атрибутами, как в ролике, ChatGPT как инструменты не берёт, он их просто заполняет обычными кликами. Apple официально против этой затеи.
Новые метрики из ролика это экспериментальная категория Agentic Browsing в Lighthouse. Оценки 0‑100 там нет, сама Google называет её «informational and unbenchmarked», то есть для справки и без эталона. На позиции в поиске она не влияет.
Вердикт. Сейчас не нужно. Заложить на будущее и включать, когда выйдет Chrome 157 и агенты начнут этим реально пользоваться.
Как есть. llms.txt предложил один человек, Джереми Говард из Answer.AI, в 2024 году, и до сих пор это предложение, а не стандарт. Механизма, который разрешает или запрещает обучение, в нём нет вообще, сам автор пишет, что это задача robots.txt. Google Search файл игнорирует: не помогает и не вредит.
Замеры по логам. Ahrefs на 137 тысячах доменов: у 97% сайтов с этим файлом за месяц ноль запросов к нему. SE Ranking на 300 тысячах доменов: наличие llms.txt на частоту цитирования нейросетями не влияет.
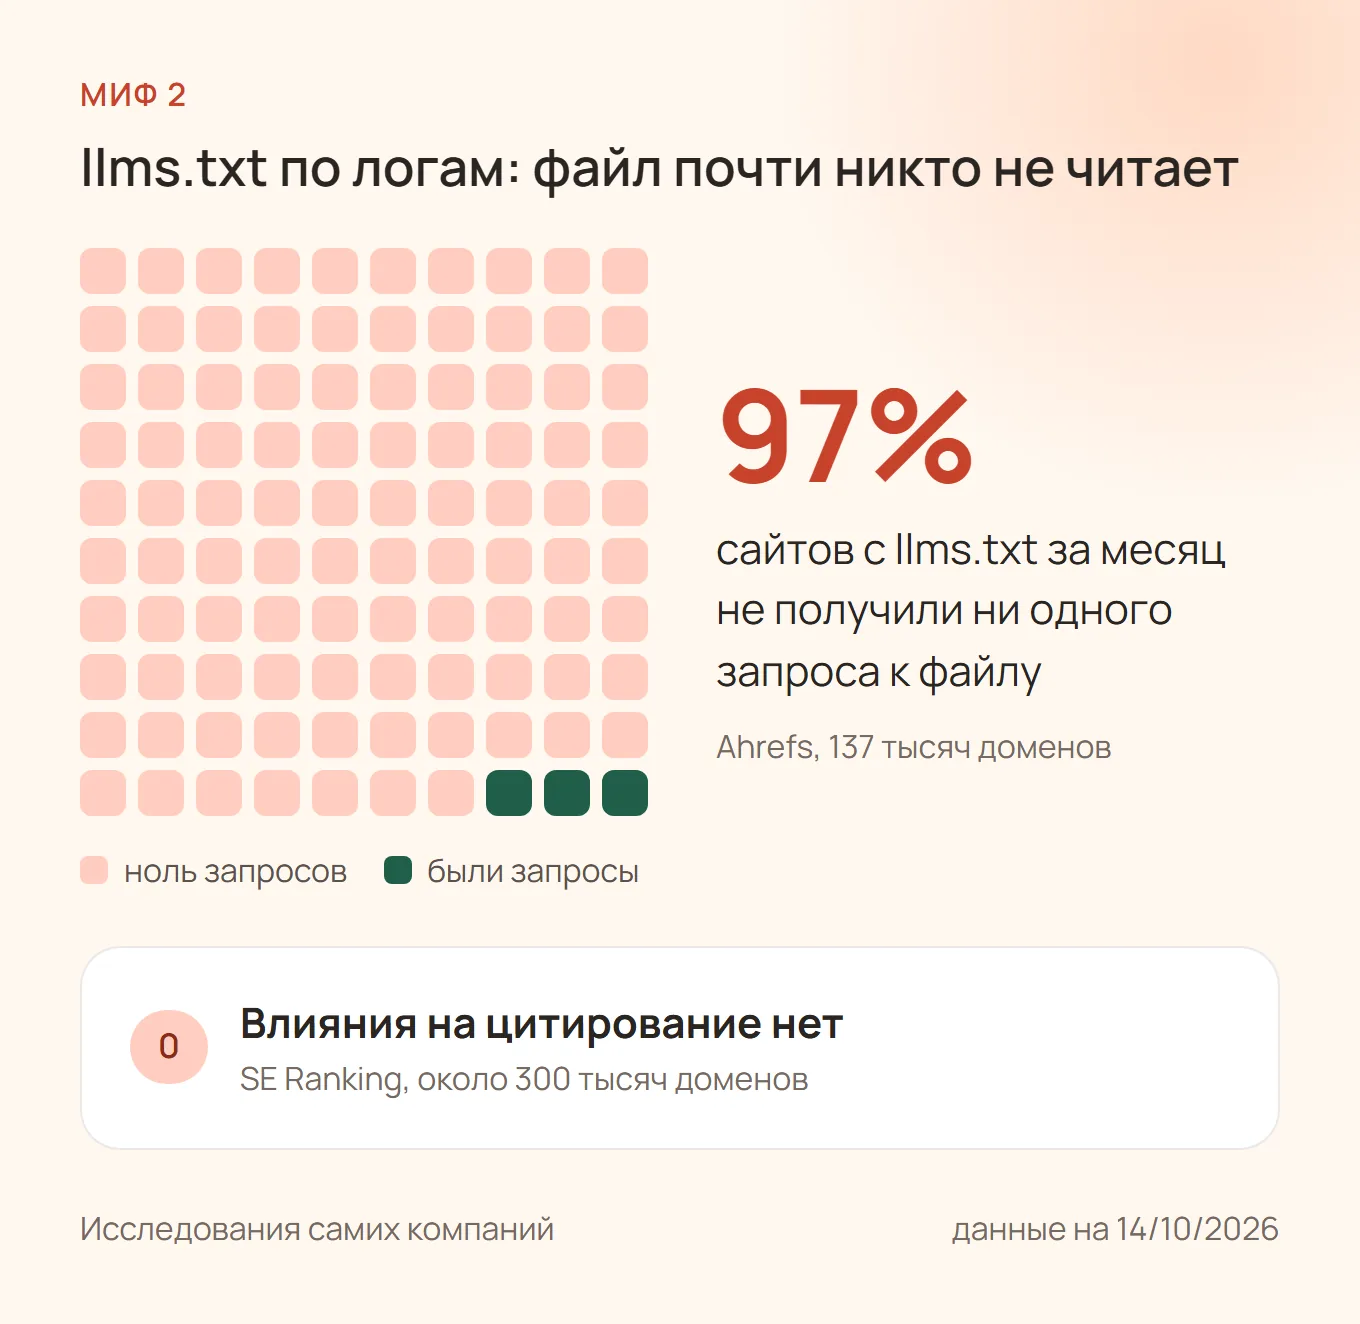
Вердикт. Час работы и вреда нет, но роста от него не ждите. Свои llms.txt держат Anthropic и Яндекс, но как оглавление документации для разработчиков, а не ради поиска.
Как есть. Файл существует, но в статусе Proposal, и в новой версии спецификации основной адрес уже сменили на /.well-known/ard.json. Описывает он не разделы сайта, а MCP-серверы, агентов и API. Через три дня после анонса ни одна из 11 компаний-основателей такой файл у себя не отдавала. На одном сайте, который его выложил в сентябре, файл не запросил ни один краулер ChatGPT, Claude, Perplexity, Google или Bing, заходил только тот же Lighthouse.
Вердикт. Обычному сайту услуг не нужен: описывать в нём нечего. Следить.
Ahrefs проверил на 1885 страницах: роста цитирований в ChatGPT и AI Mode после разметки нет. Яндекс разметку для Алисы рекомендует, но показ не обещает. Делать её стоит, но как обычное SEO, а не как пропуск в нейроответы.
User-agent: * на него не действует. Ботов для обучения (GPTBot, ClaudeBot, Google-Extended) закрыть или открыть осознанно: на поиск это не влияет.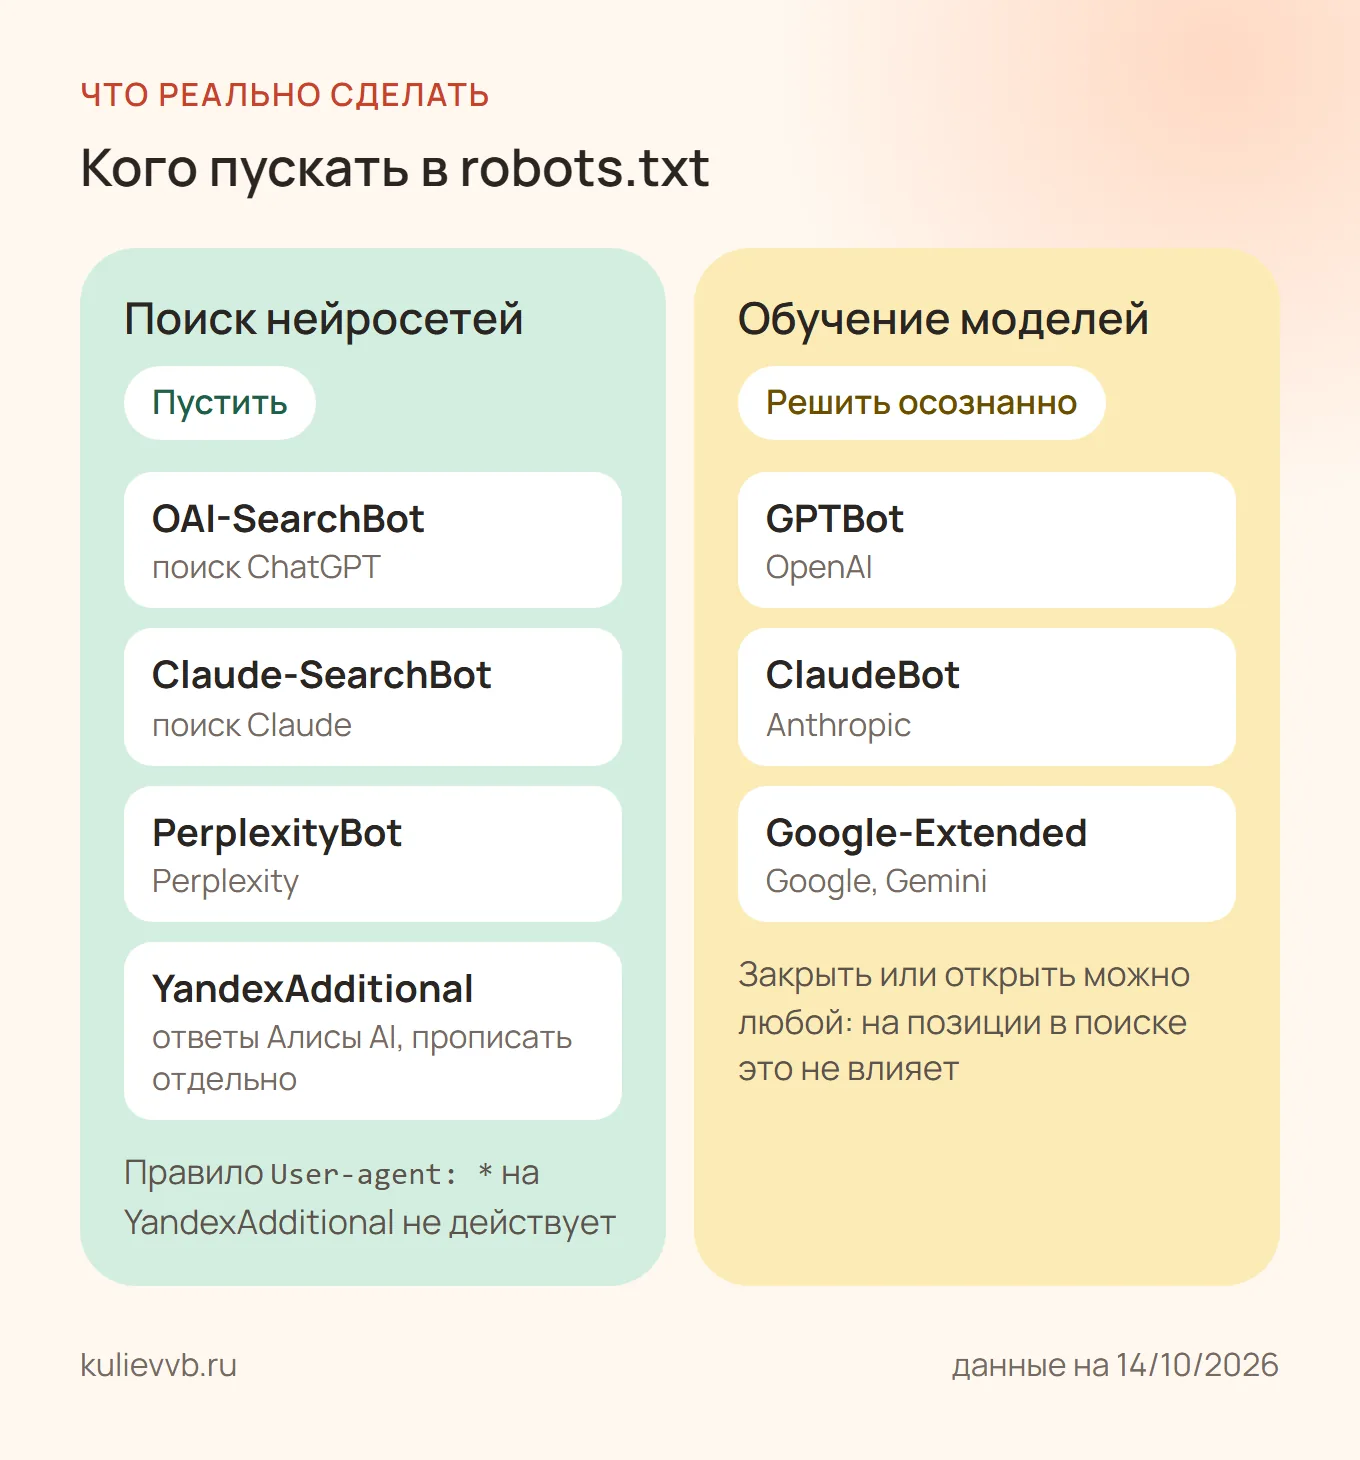
Всё это я закладываю в новую версию своего сайта. WebMCP держу в шаблоне выключенным до сигнала, ai-catalog.json не делаю.
Тема меняется быстро, данные на 14/10/2026. Часть цифр это исследования самих компаний (Ahrefs, SE Ranking, Cloudflare), я их так и помечаю. Через полгода картинка может сдвинуться, и я перепроверю.
А вам уже предлагали «подготовить сайт под нейросети» за деньги? Что именно обещали?
Клиентов показываю без названий.
Выберите свою ситуацию, покажу, что подходит и сколько стоит.
Гайд про регистрацию и оплату Claude из России: текст со скриншотами, что делать, если не проходит карта.
Схематично: вопрос про доступ и ответ из гайда
Читаете и делаете сами, живой поддержки нет.
Схематично: прохождение урока
Вы собираете своё, я рядом: в Zoom с группой или лично.
Схематично: встреча в Zoom
Разработка и ведение под ваш процесс. Типовые сайты и боты лежат в услугах.
Схематично: выбор задачи
Гайды, уроки и шаблоны без живой поддержки, в своём темпе.
Регистрация в Claude из России: номер, почта, оплата и защита от бана.
Что внутри
Sub-агенты, hooks и MCP-серверы. 10 глав, доступ навсегда.
Что внутри
Лендинг, Telegram-бот и парсер данных на Claude Code. Без поддержки.
Что внутри
Заготовки для Claude Code, MCP и n8n, чтобы не собирать с нуля.
Что внутри
Практикум и менторство я веду сам. Группа идёт неделю, менторство один месяц.
Группа 8-10 человек в Zoom, 7 встреч по 2 часа. За неделю собираете бота, сайт и таблицу-CRM на своём сервере.
Что внутри
Четыре встречи по 2 часа за месяц на вашем проекте, всего 8 часов. Беру двух человек одновременно.
Что внутри
Если делать самому некогда, я собираю и веду систему за вас.
CRM, платежи и связка систем под ваш процесс. Стандартные боты и ИИ-агентов беру как услугу.
Что внутри
Помесячное ведение собранной системы: правки, новые сценарии, отчёт.
Что внутри
Напишите мне в Telegram: подскажу, с чего начать. Или оставьте заявку, я отвечу сам.